开源实时日志分析平台-ELK
一. ELK简介
1. 什么是日志
日志就是程序产生的,遵循一定格式(通常包括时间戳)的文本数据。
通常来说,日志由服务器生成,输出到不同文件中。一般包含系统日志、应用日志、安全日志。这些日志分散的存储在不同机器中。
2. 日志的重要性
日志主要包括系统日志、应用程序日志和安全日志。系统运维和安全人员可以通过日志了解服务器软硬件信息、检查配置过程中的错误及发生的原因。经常分析日志可以了解服务器的负荷,性能安全性,从而及时采取措施纠正错误。
日志数据在以下几个方面具有非常重要的作用
- 数据查找: 通过检索日志信息,定位相应的bug,找出解决方案。
- 服务诊断: 通过日志信息进行统计、分析。了解服务器的负荷和服务运行状态
- 数据分析: 可以作进一步的数据分析,比如根据请求中的商品ID找出TOP10用户感兴趣的商品
3. 存在的问题
通常,日志被分散的存储在不同设备上。如果你管理数十上百台服务器,还在使用依次登录每台机器的传统方法查阅日志,这样会很繁琐和效率低下。所以我们需要使用集中化的日志管理。例如开源的syslog将所有服务器上的日志收集汇总。集中化管理日志后日志的统计和检索又称为比较麻烦的事。如果使用grep、awk和wc等命令实现检索和统计时,对于要求更高的查询排序和统计等要求和庞大的机器数量时也会力不从心。
4. ELK
开源实时日志分析ELK平台能够完美的解决上述问题。ELK是一个成熟的日志系统。主要功能有日志的收集、分析、检索。ELK由ElasticSearch、Logstash和Kibana三个开源工具组成。这三个工具组合成一套实用的、易用的日志管理平台。可抓取系统日志、apache日志、nginx日志、MySQL日志等多种日志类型。目前很多公司用它来搭建可视化的集中式日志分析平台。
二. ELK关系
ELK这三个开源工具的关系,简单来说就是logstash收集日志,存到elastic search(存储、产生索引、搜索),再由kibana展现。
1. ElasticSearch
是个开源分布式搜索系统。提供搜索、分析、存储数据三大功能。它主要负责将logstash抓取来的日志数据索引并存储起来。它的特点有: 分布式、零配置、自动发现、索引自动分片、索引副本机制、restful风格接口、多数据源、自动搜索负载等。数据以JSON文档的格式存储索引,不需要预先规定范式
2. Logstash
主要是用来日志的搜集、分析、过滤日志的工具,支持大量的数据获取方式。一般工作方式为C/S架构。client端安装在需要收集日志的主机上。server端负责将收到的各节点日志进行过滤、修改等操作再一并发往ElasticSearch上去。其实logstash是可以被别的替换,比如常见的fluentd。
3. Kibana
也是一个开源免费工具,Kibana可以为Logstash和ElasticSearch提供日志分析优化的Web界面。可以帮助汇总、分析和搜索重要数据日志。
ELK是这三个开源软件的缩写。加上一个新增的FileBeat,它是一个轻量级的日志收集工具(Agent),Filebeat占用资源少,适合于在各个服务器上搜索日志后传输给Logstash。同时该工具也是官方推荐的工具。
4. 扩展: ElasticSearch和传统数据库的术语对比
| RDS | ElasticSearch | 说明 |
|---|---|---|
| database | index | |
| table | type | |
| primary key | id | |
| row | JSON document | 文档是最基本的数据存储单元,因此也可以称ElasticSearch为文档型NoSQL数据库 |
| column | field | |
| schema | mapping | 可以支持动态范式,也可以将范式指定下来。从而优化对数据索引和查询 |
| index | (all) | 所有的字段都是被索引的,因此不需要手动指定索引 |
| SQL | query DSL | 不同于我们习惯的SQL语句,需要构建繁复的JSON参数来实现复杂的数据统计和查询功能 |
三. ELK优点
通俗来说,ELK是由ElasticSearch、Logstash、Kibana三个开源软件的组成的一个组合体。这三个软件当中每个软件都用于完成不同功能。ELK又称为ELK stack,官方域名为elastic.co。ELK stack的主要优点有如下几个
- 处理方式灵活: ElasticSearch是实时全文索引,具有强大的搜索功能。
- 配置相对简单: ElasticSearch全部使用JSON接口,logstash使用模块配置。Kibana的配置文件部分更简单。
- 检索性能高效: 基于优秀的设计,虽然每次查询都是实时,但是也可以达到百亿级数据的查询秒级响应。
- 集群线性扩展: ElasticSearch和logstash都可以灵活线性扩展。
- 前端操作绚丽: Kibana的前端设计比较绚丽且操作简单。Kibana界面上只需要点击鼠标就可以完成搜索、聚合功能,生成绚丽的仪表盘。
四. ELK应用场景
- 分布式部署项目,需要收集日志
- 微服务架构项目,收集各个服务的日志
- 大数据行业
ELK组件在大数据运维系统中,主要可解决的问题如下
- 日志查询,问题排查,上线检索
- 服务器监控,应用监控,错误报警,BUG管理
- 性能分析,用户行为分析,安全漏洞分析
五. ELK常见架构
1. ElasticSearch+Logstash+Kibana
此架构由Logstash分布于各个节点上搜集相关日志、数据,并经过分析、过滤后发送给远端服务器上的ElasticSearch进行存储。ElasticSearch将数据以分片的形式存储并提供多种API供用户查询,操作。用户亦可以更直观的通过配置Kibana Web方便的对日志查询,并根据数据生成报表。
这是最简单的一种ELK架构方式,优点是搭建简单易于上手。缺点是Logstash耗资源较大,运行占用CPU和内存高。另外没有消息队列缓存,存在数据丢失隐患。
2. ElasticSearch+Logstash+filebeat+Kibana

与上一种架构相比,这种架构增加了一个filebeat模块。filebeat是一个轻量的日志收集代理,用来部署在客户端。优势是消耗非常少的资源(较logstash),所以生产中往往会采取这种架构方式。此种架构将收集端logstash替换为beats。更灵活消耗资源更少,扩展性更强。同时可以配置Logstash和ElasticSearch集群用于支持大集群的运维日志数据监控和查询。但是这种架构有一个缺点,没有队列缓存,当logstash出现故障,会造成日志的丢失。
轻量级日志采集框架Beats,其中包含以下六种
| 日志采集框架类型 | 作用 |
|---|---|
| Packetbeat | 用于搜集网络流量数据 |
| Heartbeat | 用于运行时间监控 |
| Filebeat | 用于搜集文件数据 |
| Winlogbeat | 用于搜集Windows事件数据 |
| Metricbeat | 用于指标 |
| Auditbeat | 用于审计数据 |
3. ElasticSearch+Logstash+filebeat+redis(kafka)+Kibana

说明:
logstash节点和ElasticSearch节点可以根据日志量伸缩节点数量,filebeat部署在每台需要收集日志的服务器上。
此种架构引入了消息队列机制,位于各个节点上的beats先将数据/日志传递给消息队列(kafka、redis、rabbitMQ等),logstash从消息队列取数据进行过滤、分析后将数据传递给ElasticSearch存储。最后Kibana将日志和数据呈现给用户。因为引入了Kafka(或者Redis),所以即使远端Logstash server因故障停止运行,数据将会先被存储下来,从而避免数据丢失。
注: Beats还不支持输出消息队列,新版本除外。5.0版本及以上
工作流程: Filebeat采集 ——> 发到Kafka ——> logstash处理从Kafka缓存的数据进行分析 ——> 输出到es ——> 显示在Kibana
- 多个独立的agent(filebeat)负责收集不同来源的数据,一个中心agent(logstash)负责汇总和分析数据。在中心agent前的Broker(使用kafka/redis实现)。一是可以提高系统的性能,二是可以提高系统的可靠性。当中心agent提取数据失败时,数据保存在kafka/redis中而不会丢失。
- 中心agent也是LogStash,从Broker中提取数据,可以执行相关的分析和处理(Filter)
- ElasticSearch用于存储最终的数据,并提供搜索功能
- Kibana提供一个简单、丰富的web界面,数据来自于ElasticSearch,支持各种查询、统计和展示。
这种模式的特点是: 这种架构适合于日志规模比较大的情况。但由于Logstash日志解析节点和ElasticSearch的负载比较重。可以将它们配置为集群模式以分担负荷。引入消息队列均衡了网络传输,从而降低了网络阻塞,尤其是丢失数据可能性。
ELK的安装方式
ELK有两种安装方式
(1) 集成环境: Logstash有一个集成包,里面包括了其全套的三个组件;也就是安装一个集成包。
(2) 独立环境: 三个组件分别单独安装、运行各司其职
六. ELK+filebeat+Kafka部署
1. 主机规划
| 主机名 | IP | 部署软件 | 备注 |
|---|---|---|---|
| ELK4 | 192.168.100.102 | Elasticsearch + Logstash + Kibana | ELK软件版本要一致 |
| ELK6 | 192.168.100.105 | nginx+filebeat | 使用filebeat收集日志 |
| ELK7 | 192.168.100.106 | Kafka+zookeeper | 这里部署节点 |
2. 环境配置
1) 版本选择
我们选择最新的8.x版本,ELK所有组件选择相同版本
2) 时间同步
所有节点都需要进行时间同步,可以使用chrony组件。执行该脚本可以直接安装
#!/bin/bash
set -e  # 任何命令失败则立即退出

echo "========== 开始配置 Chrony 时间同步 =========="

# 1. 检查网络连通性(确保能访问阿里云 NTP)
if ! ping -c 2 ntp.aliyun.com &>/dev/null; then
    echo "错误:无法 ping 通 ntp.aliyun.com,请检查网络!"
    exit 1
fi

# 2. 挂载光盘(如果已挂载则跳过)
if mount | grep -q "/media/cdrom"; then
    echo "光盘已挂载,跳过挂载步骤"
else
    mount /dev/sr0 /media/cdrom &>/dev/null || true
    sleep 2
fi

# 3. 安装 chrony
if ! rpm -q chrony &>/dev/null; then
    echo "正在安装 chrony..."
    dnf -y install chrony &>/dev/null
else
    echo "chrony 已安装,跳过安装"
fi

# 4. 备份原配置文件(如果未备份)
if [ ! -f /etc/chrony.conf.bak ]; then
    cp /etc/chrony.conf /etc/chrony.conf.bak
fi

# 5. 彻底清理旧配置,写入全新的干净配置(解决重复追加问题)
cat > /etc/chrony.conf << EOF
# 阿里云 NTP 服务器(国内首选)
server ntp.aliyun.com iburst
server ntp1.aliyun.com iburst
server ntp2.aliyun.com iburst
server ntp3.aliyun.com iburst

# 本地时间偏差记录文件
driftfile /var/lib/chrony/drift

# 如果本机网络时间偏差过大,允许快速跳跃修正
makestep 1.0 3

# 允许内网客户端同步(如果你后面要用其中一台做内网 NTP,可取消注释)
# allow 192.168.0.0/16
EOF

# 6. 重启 chronyd 并强制立即同步
systemctl restart chronyd
systemctl enable chronyd
sleep 3
chronyc -a makestep &>/dev/null || true

# 7. 验证同步状态
if chronyc sources -v | grep -q '^\^\*'; then
    echo "✅ chrony 同步成功!"
    echo "当前系统时间:$(date)"
    echo "详细同步状态:"
    chronyc tracking | grep -E "Reference ID|Stratum|Last offset"
else
    echo "❌ chrony 同步失败,请检查日志:journalctl -u chronyd -n 20"
    exit 1
fi
3. ELK部署
直接粘贴如下命令到终端
# 1. 导入 Elastic GPG key
rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearch

# 2. 添加 Elastic 8.x 仓库
cat > /etc/yum.repos.d/elastic.repo <<EOF
[elasticsearch]
name=Elasticsearch repository for 8.x packages
baseurl=https://artifacts.elastic.co/packages/8.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md
EOF

# 3. 安装三个组件
dnf install -y elasticsearch logstash kibana
0) 安装jdk-21(rpm包安装的自带jdk,没必要装)
wget https://download.oracle.com/java/21/latest/jdk-21_linux-x64_bin.tar.gz
tar -xf jdk-21_linux-x64_bin.tar.gz -C /usr/local
tee /etc/profile.d/java.sh << 'EOF'
  export JAVA_HOME=/usr/local/jdk-21.0.12
  export PATH=$JAVA_HOME/bin:$PATH
  export ES_JAVA_HOME=$JAVA_HOME
EOF
source /etc/profile.d/java.sh
java -version
顺便写入hosts文件
hostnamectl set-hostname ELK4
cat << EOF | tee -a /etc/hosts
192.168.100.102 ELK4
192.168.100.105 ELK6
192.168.100.106 ELK7
EOF
1) 为Elastic Search另外创建用户
因为我们是用rpm包安装的,安装时就自带elasticsearch用户,所以不需要再额外创建了
2) 修改内核参数,确保系统有足够资源启动ES
注: vm.max_map_count这个参数就是允许一个进程在VMA(Virtual Memory Areas,虚拟内存区域),拥有最大数量,虚拟内存区域是一个连续的虚拟地址空间区域。在进程的生命周期中每当程序尝试在内存中映射文件,连接到共享内存段,或者分配堆空间的时候这些区域将被创建。调优这个值将限制进程可以拥有VMA的数量,当达到vm.max_map_count就会返回out of memory errors。
这个参数也可以通过下面的命令来查看: cat /proc/sys/vm/max_map_count
可以通过命令cat /proc/{pid}/maps|wc -l来监控,当前进程使用到的vm映射数量。
3) 设置资源参数
cat << EOF | tee -a /etc/security/limits.conf
# 表示任何一个用户可以打开的最大文件数量
*soft nofile 65536
*hard nofile 65536
# 表示任何一个用户可以打开的最大进程数
*soft nproc 65536
*hard nproc 65536
EOF
4) 修改ElasticSearch主配置文件
先查看
[root@4 ~]# rpm -qc elasticsearch
/etc/elasticsearch/elasticsearch-plugins.example.yml
/etc/elasticsearch/elasticsearch.yml
/etc/elasticsearch/jvm.options
/etc/elasticsearch/log4j2.properties
/etc/elasticsearch/role_mapping.yml
/etc/elasticsearch/roles.yml
/etc/elasticsearch/users
/etc/elasticsearch/users_roles
/etc/sysconfig/elasticsearch
/usr/lib/sysctl.d/elasticsearch.conf
/usr/lib/systemd/system/elasticsearch.service
主配置文件是 /etc/elasticsearch/elasticsearch.yml
需要注意的行
[root@4 ~]# vi /etc/elasticsearch/elasticsearch.yml
#cluster.name: my-application                                                       # 集群名称,同一集群的标识
#node.name: node-1                                                                  # 节点名称
path.data: /var/lib/elasticsearch                                                   # 数据存储位置
path.logs: /var/log/elasticsearch                                                   # 日志文件位置
#network.host: 192.168.0.1                                                          # ES监听地址,不能写网段,建议改成0.0.0.0让所有地址都能监听
#http.port: 9200                                                                    # 监听端口,ES节点和外部通讯使用,默认端口9200
#cluster.initial_master_nodes: ["node-1", "node-2"]                                 # 设置一系列符合主节点条件的主机名或IP地址来引导启动集群
...
执行如下命令修改(二选一)
sed -i -e 's@#cluster.name: my-application@cluster.name: my-application@' \
    -e 's@#node.name: node-1@node.name: node-1@' \
    -e 's@#network.host: 192.168.0.1@network.host: 0.0.0.0@' \
    -e 's@#http.port: 9200@http.port: 9200@' \
    -e 's@.*cluster.initial_master_nodes:.*@cluster.initial_master_nodes: ["node-1"]@' \
/etc/elasticsearch/elasticsearch.yml
或者用如下内容替换掉配置文件(二选一)
cluster.name: my-application
node.name: node-1
path.data: /var/lib/elasticsearch
path.logs: /var/log/elasticsearch
network.host: 0.0.0.0
http.port: 9200
cluster.initial_master_nodes: ["node-1"]
xpack.security.enabled: true
xpack.security.enrollment.enabled: true
xpack.security.http.ssl:
  enabled: true
  keystore.path: certs/http.p12
xpack.security.transport.ssl:
  enabled: true
  verification_mode: certificate
  keystore.path: certs/transport.p12
  truststore.path: certs/transport.p12
http.host: 0.0.0.0
5) 启动ElasticSearch
systemctl start elasticsearch
systemctl enable elasticsearch

: <<'EOF'
注: elasticsearch默认不允许root用户直接启动,但是`systemctl start elasticsearch`命令会让elasticsearch用户启动服务所以不用管
如果是使用源码包或二进制包安装的,需要创建用户后先加上权限`chown -R elasticsearch.elasticsearch /usr/local/elasticsearch*`,再使用命令`sudo -u elasticsearch /usr/local/elasticsearch*/bin/elasticsearch `后台启动
EOF
6) 查看端口和服务情况
# 查看服务状态
[root@4 ~]# systemctl status elasticsearch
● elasticsearch.service - Elasticsearch
     Loaded: loaded (/usr/lib/systemd/system/elasticsearch.service; enabled; preset: disabled)
     Active: active (running) since Wed 2026-08-05 10:39:47 CST; 2min 53s ago
       Docs: https://www.elastic.co
   Main PID: 12663 (java)
      Tasks: 84 (limit: 10844)
     Memory: 1.2G
        CPU: 40.268s
     CGroup: /system.slice/elasticsearch.service
             ├─12663 /usr/share/elasticsearch/jdk/bin/java -Xms4m -Xmx64m -XX:+UseSerialGC -Dcli.name=server -Dcli.script=/usr/share/elasticsearch/bin/elasticsearch -Dcli.libs=lib/tools/server-cli -De>
             ├─12725 /usr/share/elasticsearch/jdk/bin/java -Des.networkaddress.cache.ttl=60 -Des.networkaddress.cache.negative.ttl=10 -XX:+AlwaysPreTouch -Xss1m -Djava.awt.headless=true -Dfile.encodin>
             └─12746 /usr/share/elasticsearch/modules/x-pack-ml/platform/linux-x86_64/bin/controller

8月 05 10:39:26 4 systemd[1]: Starting Elasticsearch...
8月 05 10:39:47 4 systemd[1]: Started Elasticsearch.

# 查看端口占用情况
[root@4 ~]# ss -tuanp|grep 9200
tcp   LISTEN 0      4096                 *:9200               *:*     users:(("java",pid=12725,fd=570))

# 查看进程
[root@4 ~]# jps -m
1379 Elasticsearch
810 CliToolLauncher -p /var/run/elasticsearch/elasticsearch.pid --quiet
1595 Jps -m
# 限制内存
# 在 jvm.options.d 下新建文件,ES 启动时会自动读取
cat > /etc/elasticsearch/jvm.options.d/heap.options <<'EOF'
-Xms512m
-Xmx512m
EOF

# 确认写入
cat /etc/elasticsearch/jvm.options.d/heap.options

# 重启
systemctl restart elasticsearch

# 验证
ps aux | grep elasticsearch | grep Xms
free -m
7) ElasticSearch测试
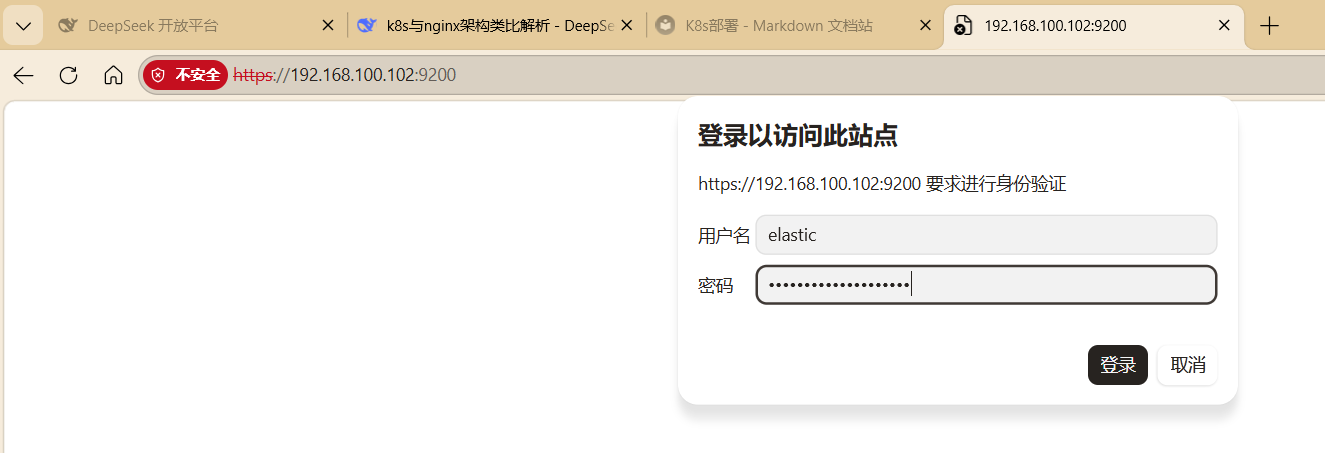
a. 生成新的密码
[root@4 ~]# /usr/share/elasticsearch/bin/elasticsearch-reset-password -u elastic
warning: ignoring JAVA_HOME=/usr/local/jdk-21.0.12; using ES_JAVA_HOME
...
Please confirm that you would like to continue [y/N]y
...
New value: 1STiGlFV5_hyTBVycl=v
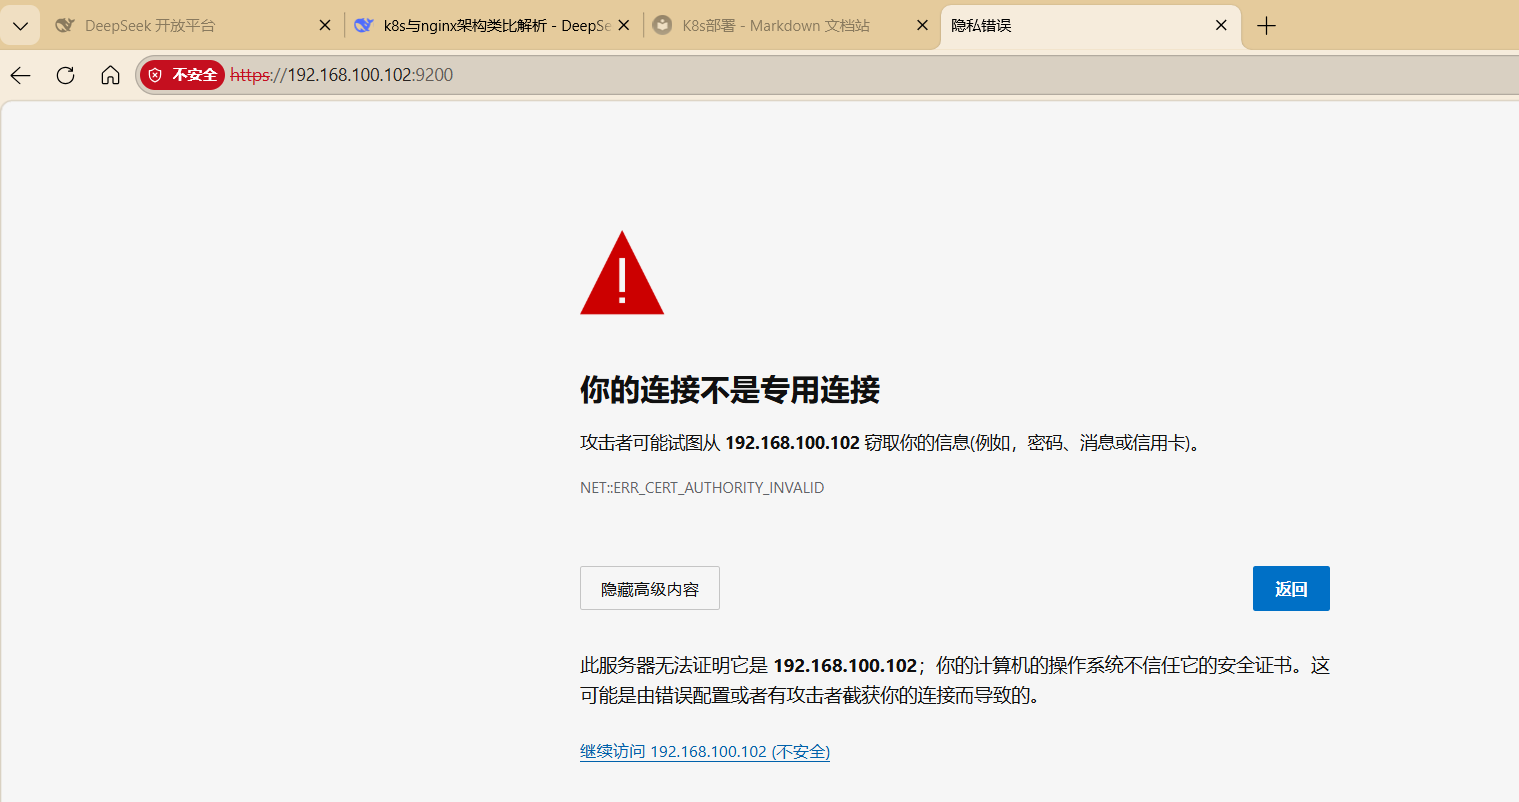
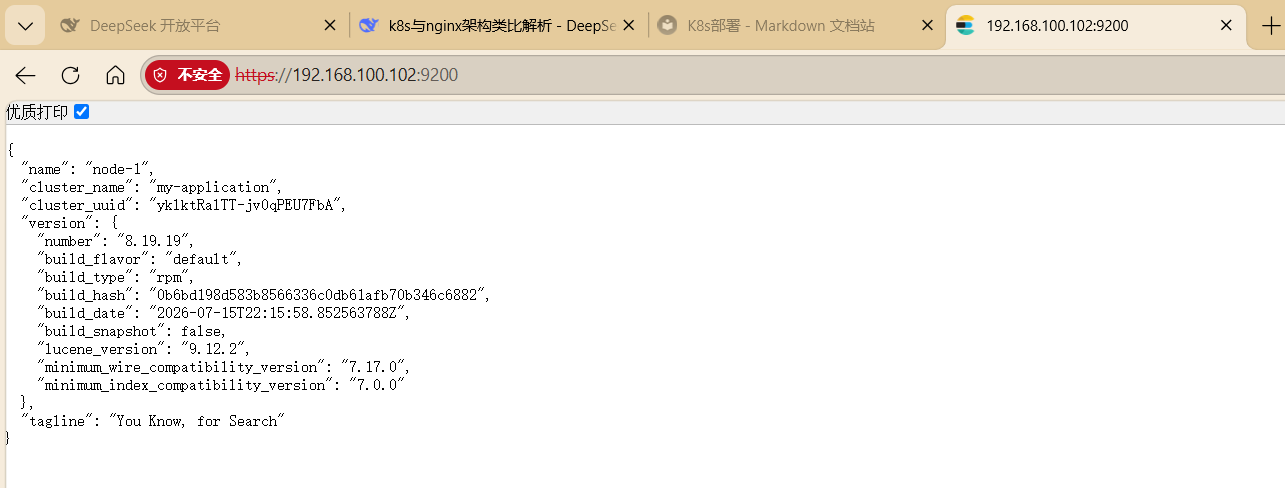
b. 在浏览器上访问证
8) 取消认证
...
xpack.security.enabled: true                                # ① 安全总开关(需要密码登录)

xpack.security.enrollment.enabled: true                     # ② 节点注册(Kibana 连接用)

# Enable encryption for HTTP API client connections, such as Kibana, Logstash, and Agents
xpack.security.http.ssl:
  enabled: true                                             # ③ HTTPS 加密

  # Enable encryption and mutual authentication between cluster nodes
xpack.security.transport.ssl:
  enabled: true                                             # ④ 节点间通信加密
...
在实验环境下,我们要将这四处enabled: true改成false就可以了
sed -i 's@enabled: true@enabled: false@' /etc/elasticsearch/elasticsearch.yml
systemctl restart elasticsearch
4. 安装logstash
之前我们已经使用命令dnf install -y elasticsearch logstash kibana安装过了,所以只需要调整修改就可以了
1) 调 JVM 堆
sed -i 's/^-Xms1g/-Xms512m/' /etc/logstash/jvm.options
sed -i 's/^-Xmx1g/-Xmx512m/' /etc/logstash/jvm.options
2) 修改配置文件
[root@4 ~]# rpm -qc logstash|grep logstash
/etc/default/logstash
/etc/logstash/jvm.options
/etc/logstash/log4j2.properties
/etc/logstash/logstash-sample.conf
/etc/logstash/logstash.yml
/etc/logstash/pipelines.yml
/etc/logstash/startup.options
/lib/systemd/system/logstash.service
其中/etc/logstash/logstash.yml是主配置文件
需要修改的有这几行
# node.name: test
# api.http.host: 127.0.0.1
# api.http.port: 9600-9700
#xpack.monitoring.elasticsearch.hosts: ["https://es1:9200", "https://es2:9200"]
#xpack.monitoring.elasticsearch.username: logstash_system
#xpack.monitoring.elasticsearch.password: password
方法1: 使用sed命令修改
sed -i -e 's@# node.name: test@node.name: node-1@' \
    -e 's@# api.http.host: 127.0.0.1@api.http.host: 0.0.0.0@' \
    -e 's@# api.http.port: 9600-9700@api.http.port: 9600@' \
    -e 's@#xpack.monitoring.elasticsearch.hosts.*@xpack.monitoring.elasticsearch.hosts: ["http://192.168.100.102:9200"]@' \
    -e 's@#xpack.monitoring.elasticsearch.username: logstash_system@xpack.monitoring.elasticsearch.username: "elastic"@' \
    -e 's@#xpack.monitoring.elasticsearch.password: password@xpack.monitoring.elasticsearch.password: "1STiGlFV5_hyTBVycl=v"@' \
/etc/logstash/logstash.yml
或者把这段粘贴进去(方法2)
node.name: node-1
path.data: /var/lib/logstash
api.http.host: 0.0.0.0
api.http.port: 9600
path.logs: /var/log/logstash
xpack.monitoring.elasticsearch.username: "elastic"
xpack.monitoring.elasticsearch.password: "1STiGlFV5_hyTBVycl=v"
xpack.monitoring.elasticsearch.hosts: ["http://192.168.100.102:9200"]
配置/etc/logstash/conf.d/logstash.conf文件
input {
# input plugin 让logstash可以读取特定的事件源
    file {
    # file从文件读取数据
        path => "/var/log/messages"
        # 收集来源,这里从输入的文件路径收集系统日志。可以用/var/log/*.log,/var/log/**/*.log。如果是/var/log则是/var/log/*.log。
        type => "message_log"
        # 通用选项,用于激活过滤器
        start_position => "end"
        # start_position 选择logstash开始读取文件的位置。begining或者end。end从日志的尾部开始读取。也就是说仅仅读取新添加的内容。对于一些更新的日志类型的监听通常是直接使用
        #end就可以了;相反begining就会从一个文件的头开始读取。但是如果记录了文件的读取信息,这个配置也就失去作用了
    }
}
filter {
# 过滤器插件。对事件执行中间处理、过滤。为空则不过滤。
}
output {
# 输出插件,将事件发送到特定目标。
    elasticsearch {
    # 将事件发送到es,在es中存储日志
        hosts => ["http://192.168.100.102:9200"]
        user => "elastic"
        password => "1STiGlFV5_hyTBVycl=v"
        index => "var-messages-%{+yyyy.MM.dd}"
        # index表示事件写入的索引。可以按照日志来创建索引。以便于产出旧数据和按照时间来搜索日志
    }
    stdout { codec =>rubydebug }
    # 标准输出。输出到当前终端显示屏
}
3) 给/var/log/messages赋权
4) 语法检测,通过后启动服务并查看
[root@4 ~]# /usr/share/logstash/bin/logstash -t --path.settings /etc/logstash
Using bundled JDK: /usr/share/logstash/jdk
Sending Logstash logs to /var/log/logstash which is now configured via log4j2.properties
[2026-08-05T17:02:53,324][WARN ][logstash.runner          ] NOTICE: Running Logstash as a superuser is strongly discouraged as it poses a security risk. Set 'allow_superuser' to false for better security.
[2026-08-05T17:02:53,334][INFO ][logstash.runner          ] Log4j configuration path used is: /etc/logstash/log4j2.properties
[2026-08-05T17:02:53,337][INFO ][logstash.runner          ] Starting Logstash {"logstash.version"=>"8.19.19", "jruby.version"=>"jruby 9.4.15.0 (3.1.7) 2026-06-08 6114208a31 OpenJDK 64-Bit Server VM 21.0.11+10-LTS on 21.0.11+10-LTS +indy +jit [x86_64-linux]"}
[2026-08-05T17:02:53,339][INFO ][logstash.runner          ] JVM bootstrap flags: [-Xms512m, -Xmx512m, -Djava.awt.headless=true, -Dfile.encoding=UTF-8, -Djruby.compile.invokedynamic=true, -XX:+HeapDumpOnOutOfMemoryError, -Djava.security.egd=file:/dev/urandom, -Dlog4j2.isThreadContextMapInheritable=true, -Djruby.regexp.interruptible=true, -Djdk.io.File.enableADS=true, --add-exports=jdk.compiler/com.sun.tools.javac.api=ALL-UNNAMED, --add-exports=jdk.compiler/com.sun.tools.javac.file=ALL-UNNAMED, --add-exports=jdk.compiler/com.sun.tools.javac.parser=ALL-UNNAMED, --add-exports=jdk.compiler/com.sun.tools.javac.tree=ALL-UNNAMED, --add-exports=jdk.compiler/com.sun.tools.javac.util=ALL-UNNAMED, --add-opens=java.base/java.security=ALL-UNNAMED, --add-opens=java.base/java.io=ALL-UNNAMED, --add-opens=java.base/java.nio.channels=ALL-UNNAMED, --add-opens=java.base/sun.nio.ch=ALL-UNNAMED, --add-opens=java.management/sun.management=ALL-UNNAMED, -Dio.netty.allocator.maxOrder=11]
[2026-08-05T17:02:53,373][INFO ][org.logstash.jackson.StreamReadConstraintsUtil] Jackson default value override `logstash.jackson.stream-read-constraints.max-string-length` configured to `200000000` (logstash default)
[2026-08-05T17:02:53,373][INFO ][org.logstash.jackson.StreamReadConstraintsUtil] Jackson default value override `logstash.jackson.stream-read-constraints.max-number-length` configured to `10000` (logstash default)
[2026-08-05T17:02:53,374][INFO ][org.logstash.jackson.StreamReadConstraintsUtil] Jackson default value override `logstash.jackson.stream-read-constraints.max-nesting-depth` configured to `1000` (logstash default)
[2026-08-05T17:02:54,102][INFO ][org.reflections.Reflections] Reflections took 101 ms to scan 1 urls, producing 150 keys and 530 values
[2026-08-05T17:02:54,496][INFO ][logstash.javapipeline    ] Pipeline `main` is configured with `pipeline.ecs_compatibility: v8` setting. All plugins in this pipeline will default to `ecs_compatibility => v8` unless explicitly configured otherwise.
Configuration OK
[2026-08-05T17:02:54,498][INFO ][logstash.runner          ] Using config.test_and_exit mode. Config Validation Result: OK. Exiting Logstash

[root@4 ~]# systemctl start logstash
[root@4 ~]# systemctl enable logstash
Created symlink /etc/systemd/system/multi-user.target.wants/logstash.service → /usr/lib/systemd/system/logstash.service.
5) 验证
[root@4 ~]# curl -s -u elastic:1STiGlFV5_hyTBVycl=v http://localhost:9200/_cat/indices
yellow open var-messages-2026.33.05 Yql4slRhT7akn9M3MUOcaw 1 1 20000 0 1.9mb 1.9mb 1.9mb
5. 安装Kibana
之前我们已经使用命令dnf install -y elasticsearch logstash kibana安装过了,所以只需要调整修改就可以了
1) 修改配置文件
生成密码
先查看配置文件
主配置文件是/etc/kibana/kibana.yml,我们需要修改这个
需要改的行有
#server.port: 5601
#server.host: "localhost"                           # 本机的IP地址
#elasticsearch.hosts: ["http://localhost:9200"]     # 修改es的地址,多个服务器用逗号隔开
#i18n.locale: "en"
#elasticsearch.username: "kibana_system"
可以执行下列命令修改(方法1)
sed -i -e 's@#server.port: 5601@server.port: 5601@' \
    -e 's@#server.host: "localhost"@server.host: "192.168.100.102"@' \
    -e 's@#elasticsearch.hosts.*@elasticsearch.hosts: ["http://192.168.100.102:9200"]@' \
    -e 's@#i18n.locale: "en"@i18n.locale: "zh-CN"@' \
    -e 's@#elasticsearch.username: "kibana_system"@elasticsearch.username: "kibana_system"@' \
/etc/kibana/kibana.yml
也可以直接复制覆盖(方法2)
server.port: 5601
server.host: "192.168.100.102"
elasticsearch.hosts: ["http://192.168.100.102:9200"]
elasticsearch.username: "kibana_system"
elasticsearch.password: "1STiGlFV5_hyTBVycl=v"
logging:
  appenders:
    file:
      type: file
      fileName: /var/log/kibana/kibana.log
      layout:
        type: json
  root:
    appenders:
      - default
      - file
pid.file: /run/kibana/kibana.pid
i18n.locale: "zh-CN"
2) 启动服务
[root@4 ~]# systemctl start kibana
[root@4 ~]# systemctl enable kibana
Created symlink /etc/systemd/system/multi-user.target.wants/kibana.service → /usr/lib/systemd/system/kibana.service.
3) 访问验证
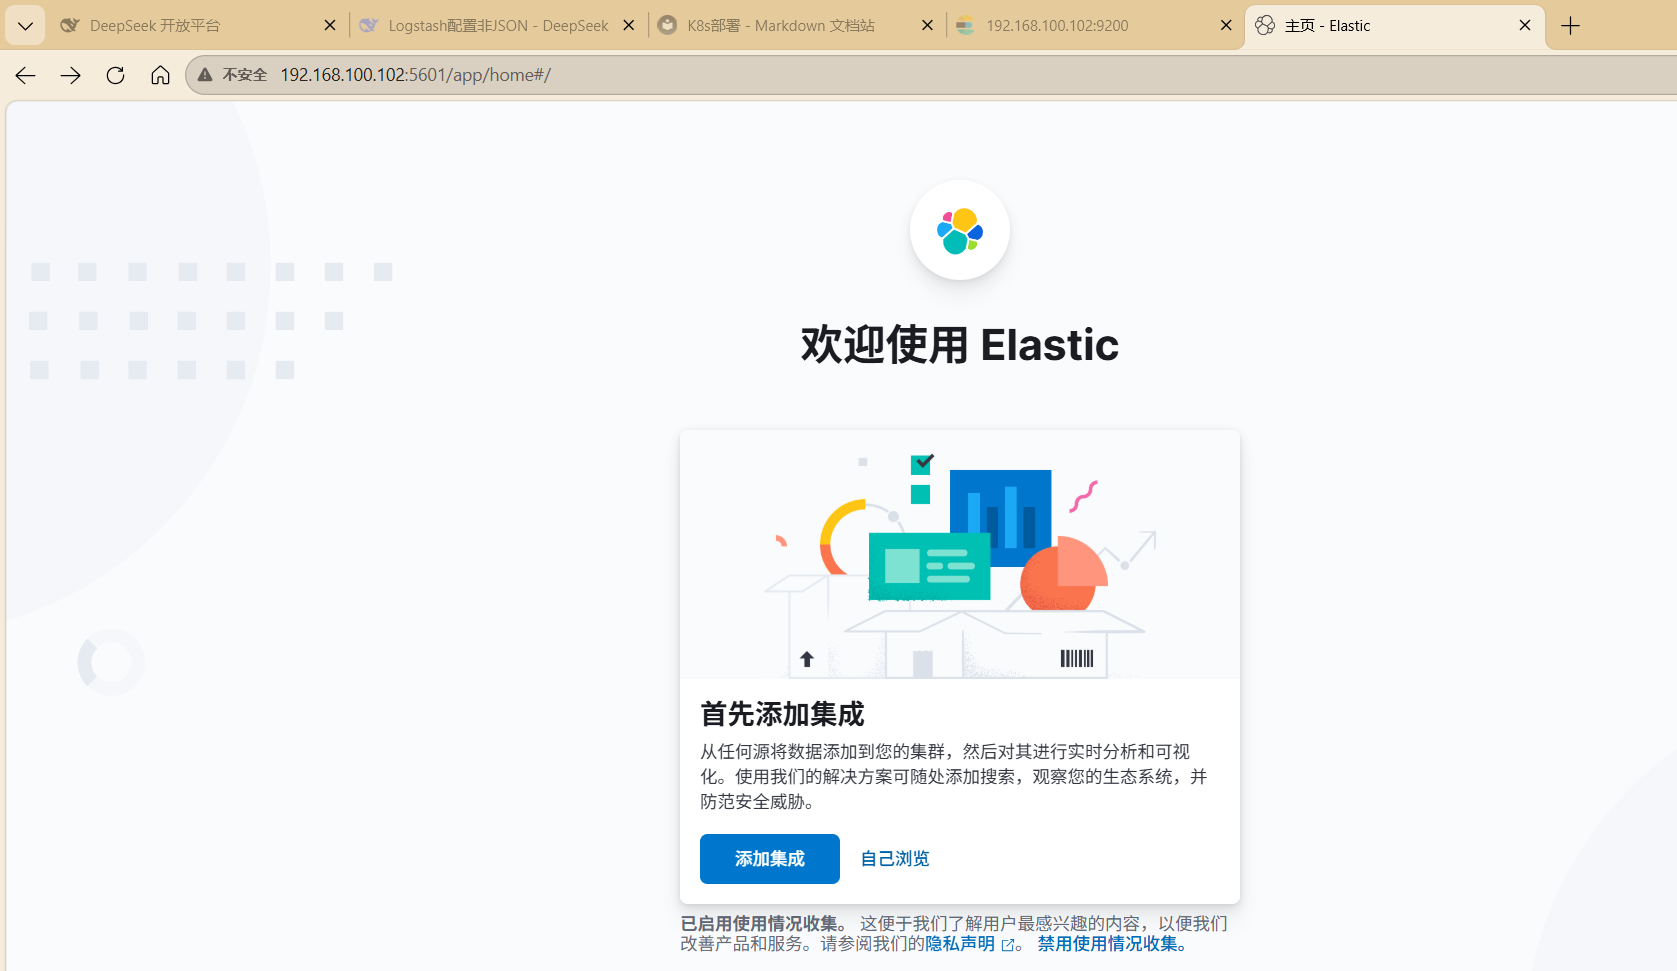
在真机浏览器输入kibana即可访问
4) 索引参数配置
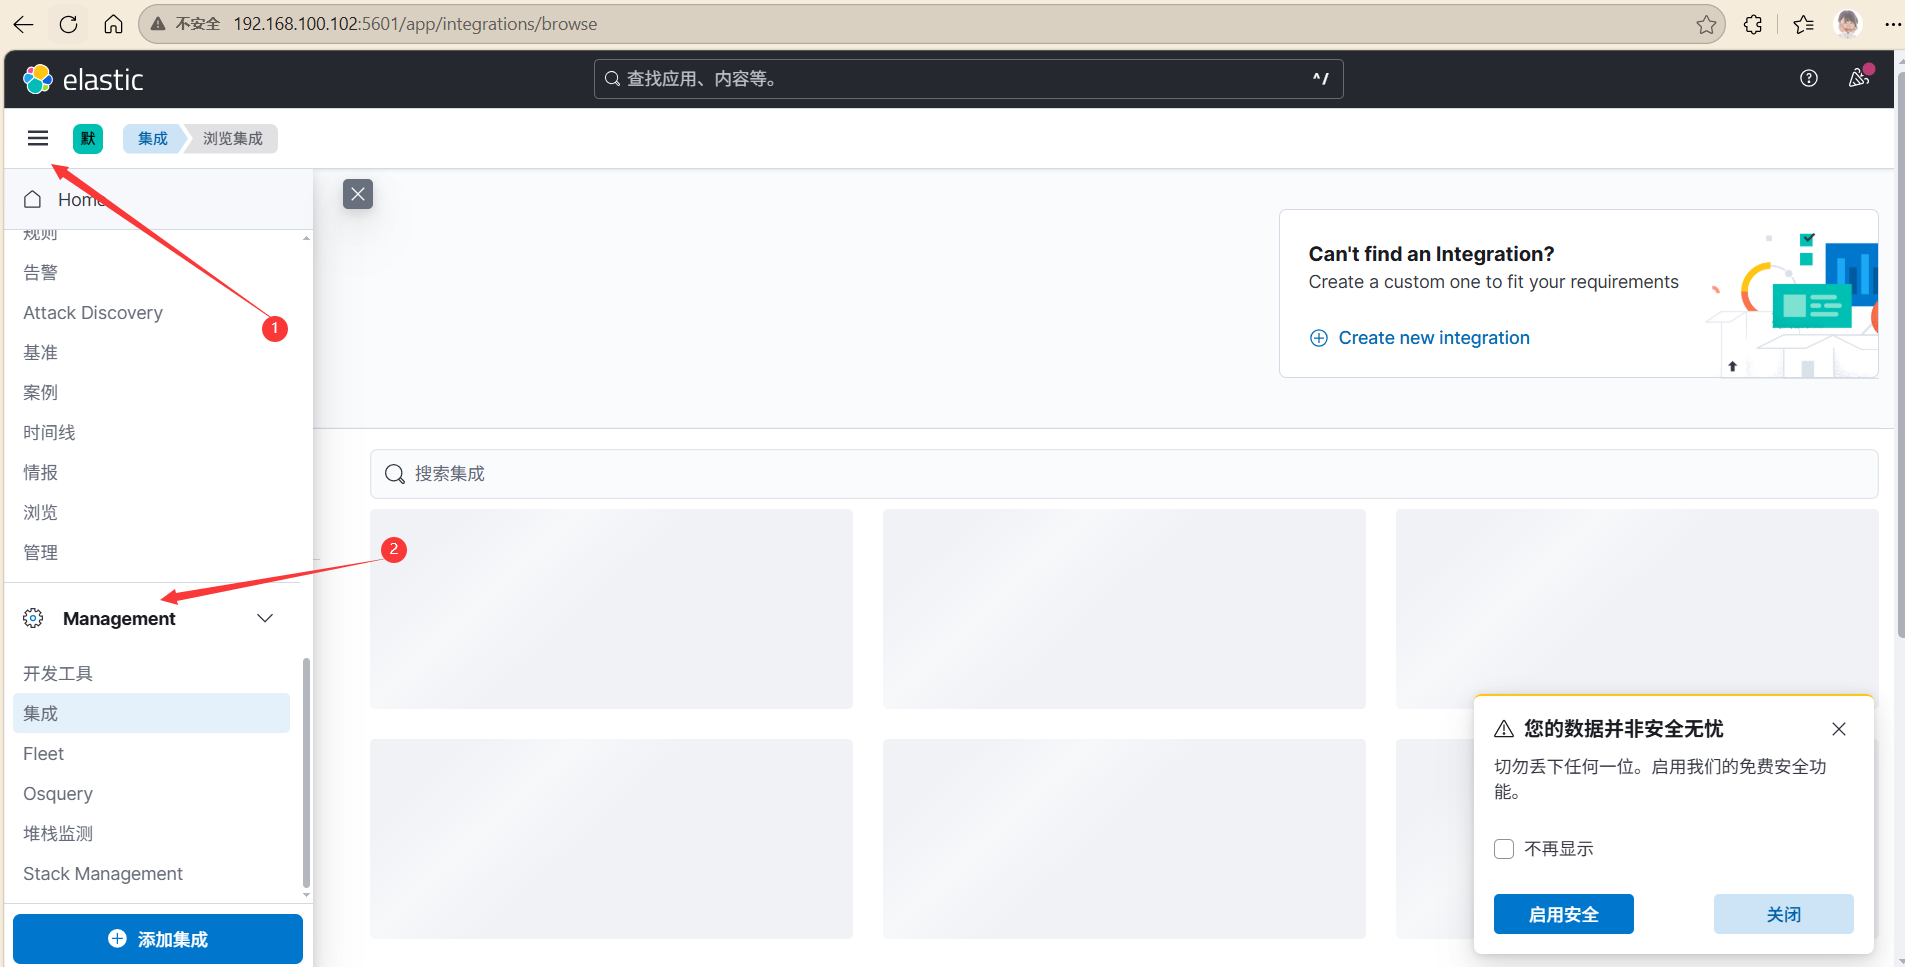
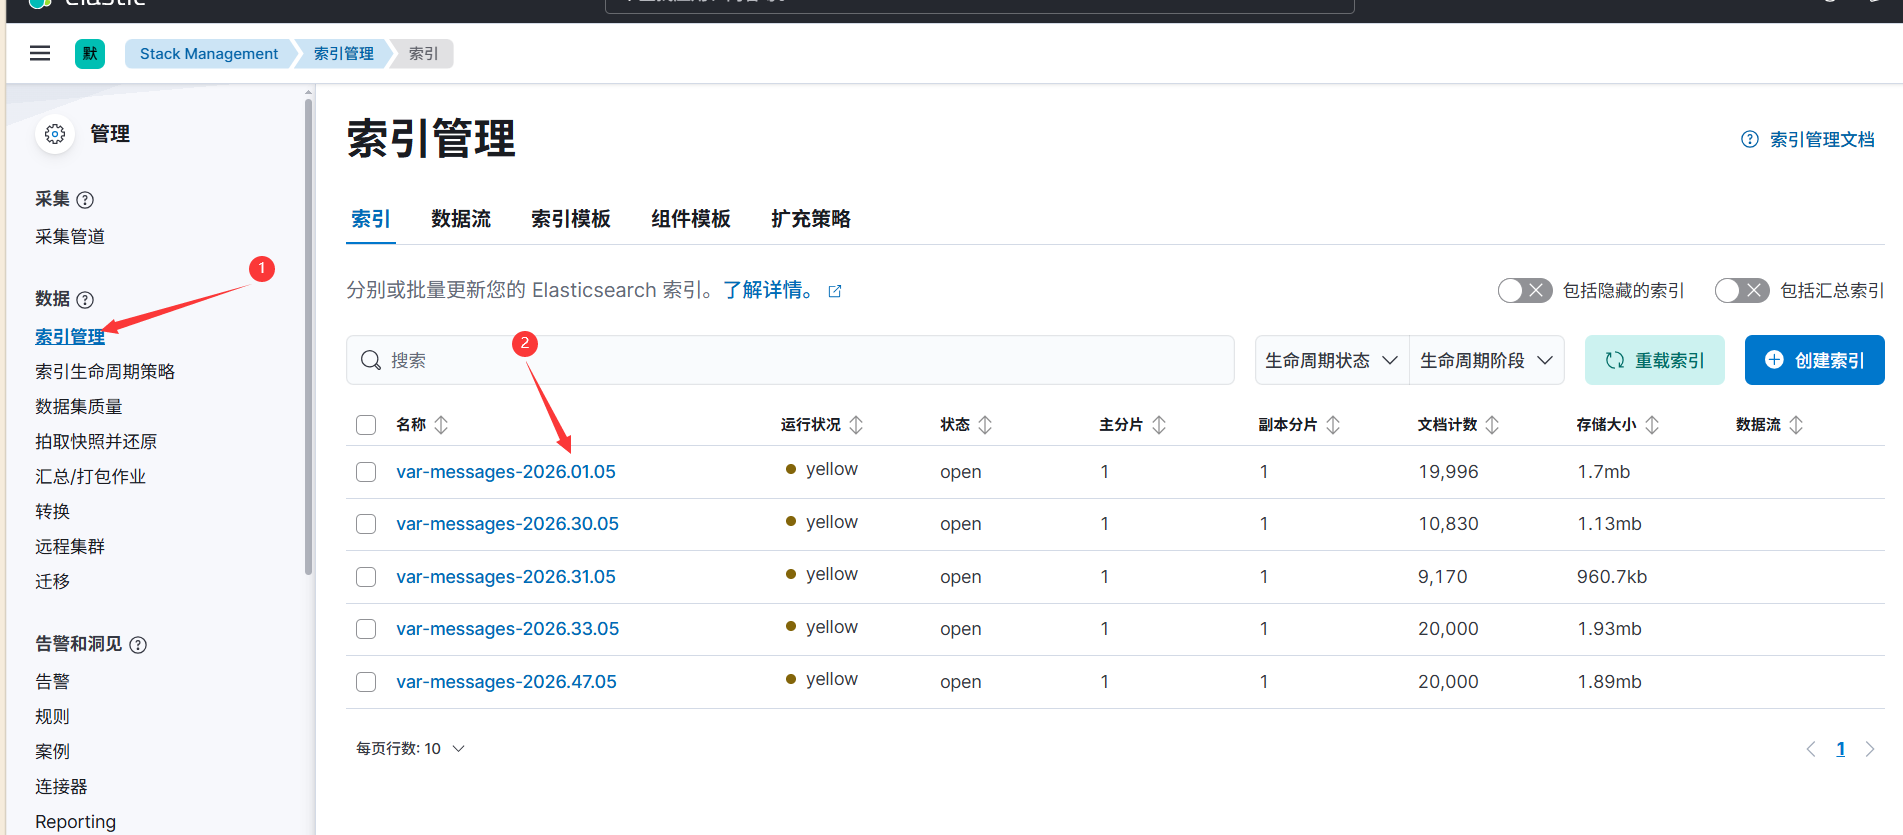
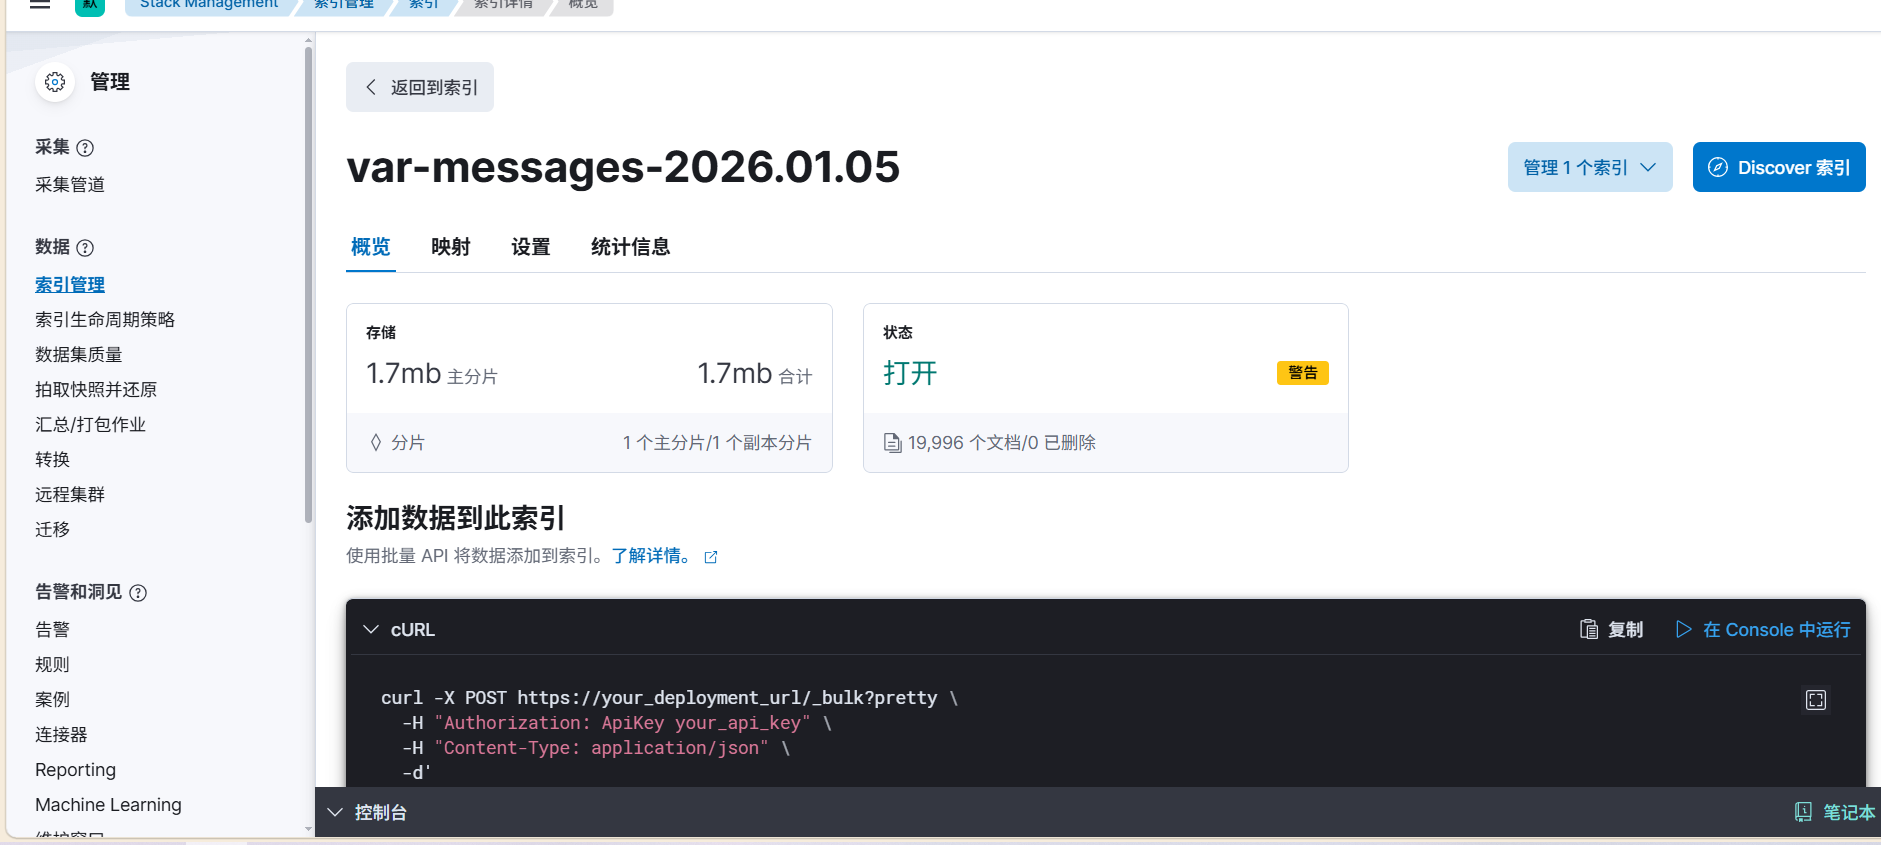
创建index视图
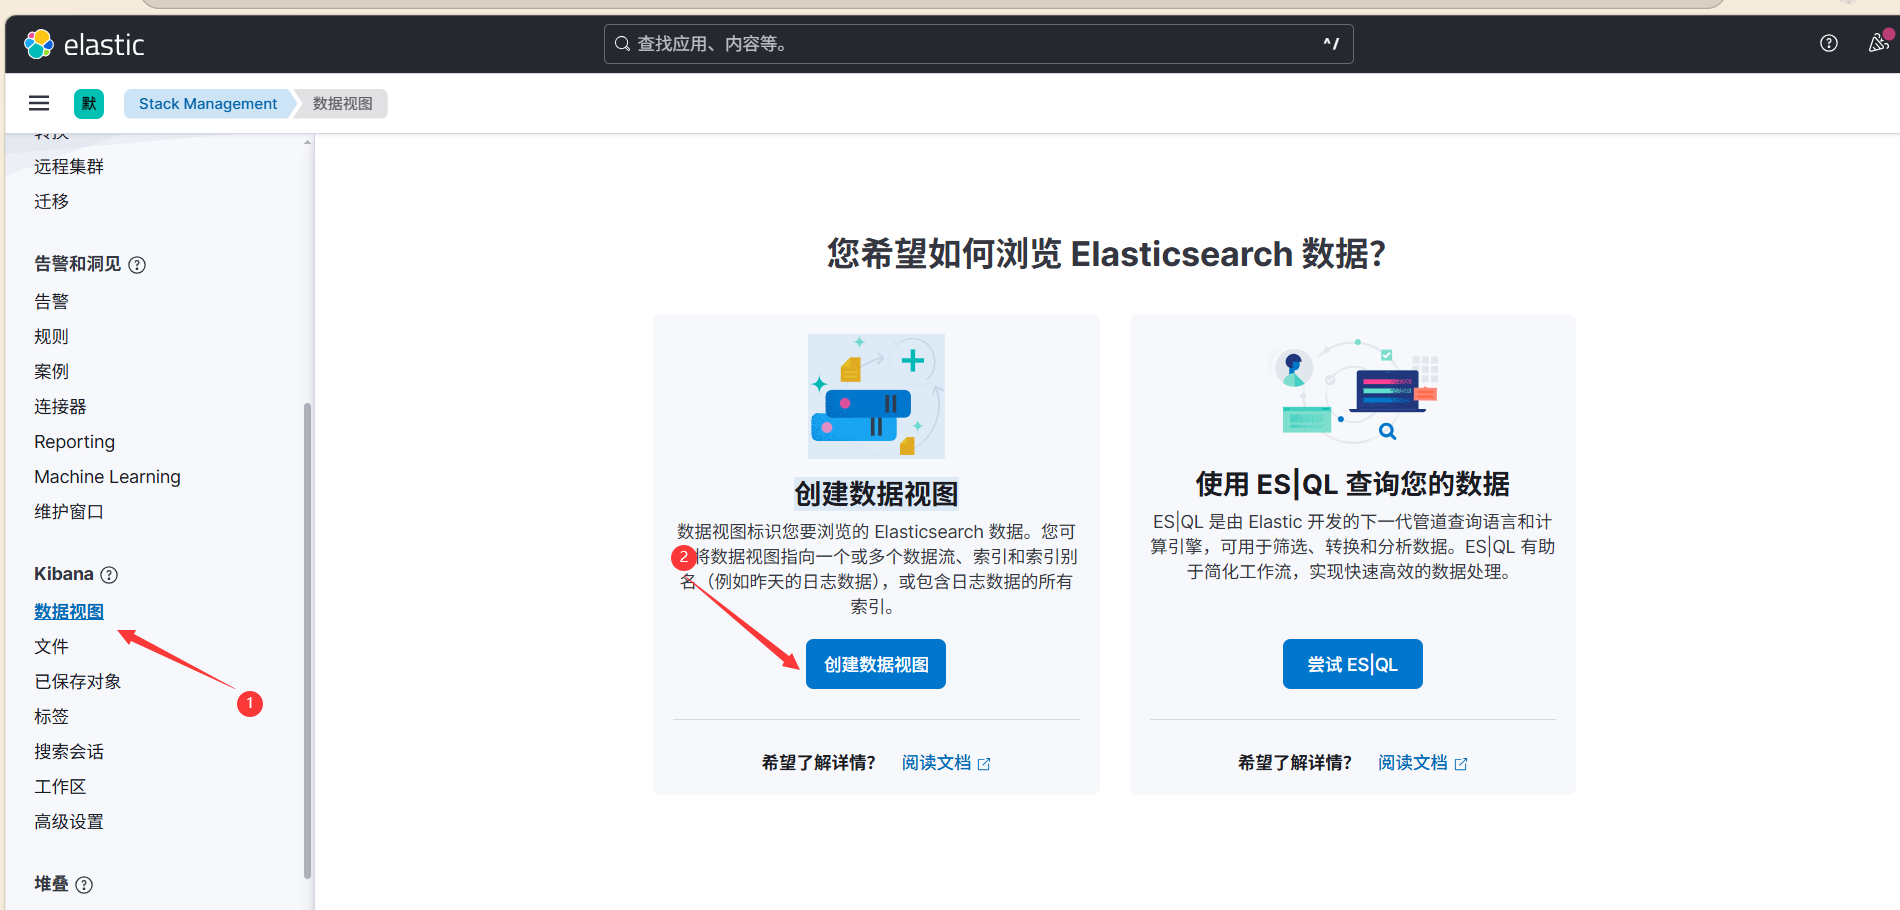
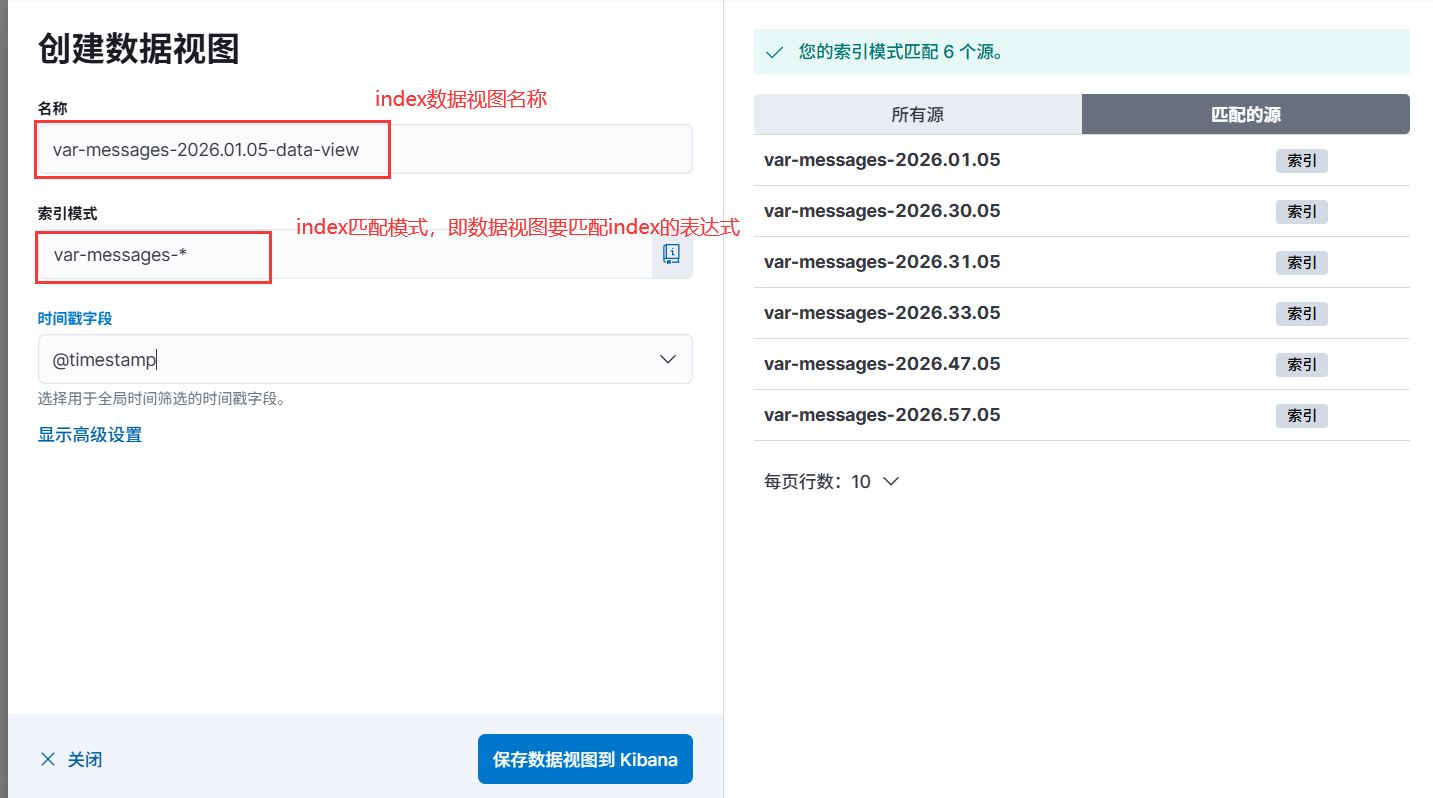
最后点击保存数据视图就可以了
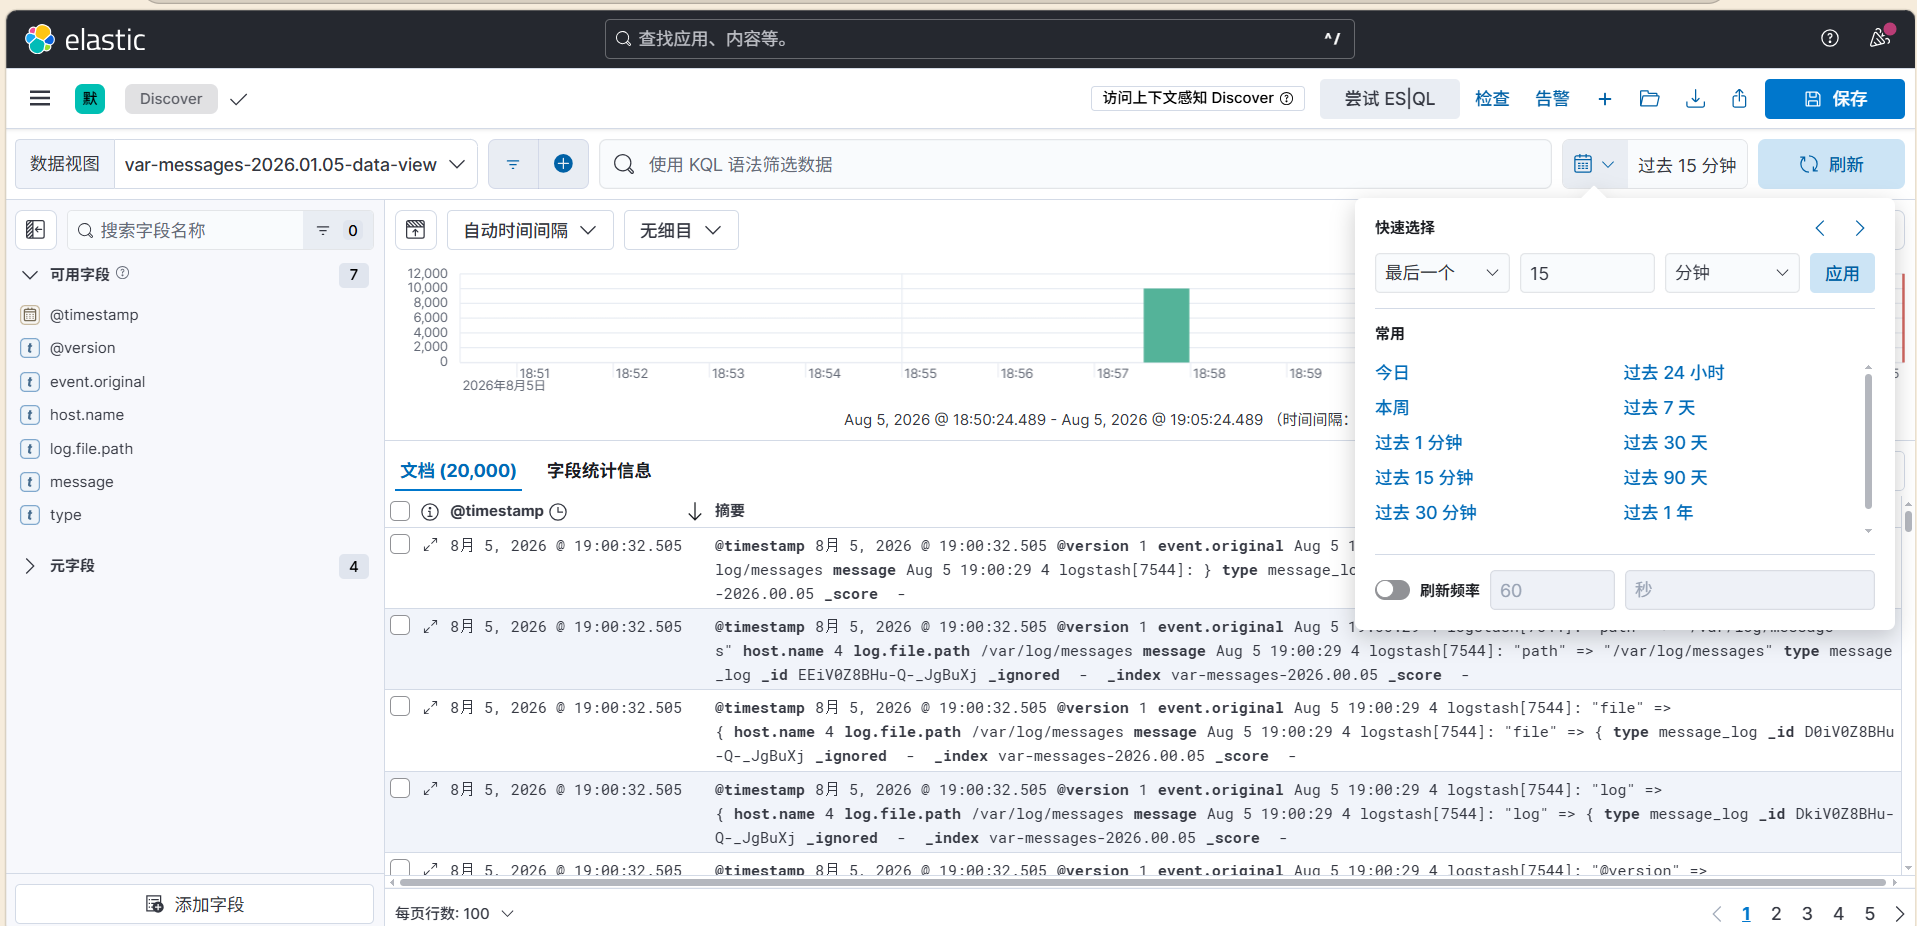
默认搜索的是最近15分钟的数据。也可以自定义时间。
到此ELK部署完毕。