消息队列(Message Queue)之kafka
一. Kafka概述
1. 为什么需要消息队列?
1). 解耦
在项目启动之初来预测项目未来会碰到什么需求,是极其困难的。消息系统在处理过程中间插入了一个隐含的、基于数据的接口层,两边的处理过程都要实现这一接口。这允许你独立的扩展或修改两边的处理过程,只要确保它们遵守同样的接口约束。
2). 冗余
消息队列把数据进行持久化直到它们已经被完全处理,通过这一方式规避了数据丢失的风险。许多消息队列所采用的"插入-获取-删除"范式中,在把一个消息队列从队列中删除之前,需要你的处理系统明确指出该消息已经被处理完毕,从而确保你的数据被安全的保存直到你使用完毕。
3). 扩展性
因为消息队列解耦了你的处理过程,所以增大消息入队和处理的频率是很容易的。只要另外增加处理过程即可。不需要修改代码,不需要调节参数。扩展就像调大电力按钮一样简单。
4). 峰值处理能力
在访问量巨大增大的情况下,应用仍需要继续发挥作用,但是这样的突发流量并不常见。如果为以能处理这类峰值访问为标准来投入资源随时待命无疑是巨大的浪费。使用消息队列能够是关键组件顶住突发的访问压力,而不会因为突发的超负荷请求而完全崩溃。
5). 可恢复性
系统的一部分组件失效时,不会影响到整个系统。消息队列降低了进程间的耦合度,所以即使一个处理消息的进程挂掉,加入队列中的消息仍然可以在系统恢复后被处理。
6). 顺序保证
在大多数使用场景下,数据处理的顺序都很关键。大部分消息队列本来就是排序的,并且能够保证数据会按照特定的顺序来处理。(Kaffa保证每一个Partition内的消息的有序性)
7). 缓冲
有助于控制和优化数据流经过系统的速度,解决生产消息和消费消息的处理速度不一致情况。
8). 异步通信
很多时候,用户不想也不需要立即处理消息。消息队列提供了异步处理机制。允许用户把一个消息放入队列,但并不会立即处理它。想向队列中放入多少消息就放多少,然后在需要的时候再去处理它们。
2. 消息队列的两种模式
常见的两种消息系统队列模型是消息队列模型和发布/订阅模型
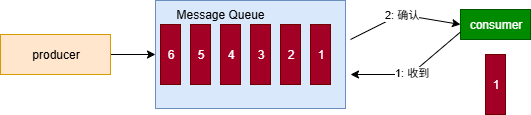
- 点对点模式(一对一,消费者主动拉去数据,消息收到后消息清除)
消息生产者生产消息发送到Queue中,然后消息消费者从Queue中取出并且消费消息。消息被消费后Queue中不再有存储,所以消息消费者不可能消费到已经被消费的消息。Queue支持存在多个消费者,但是对一个消息而言,只有一个消费者可以消费。
- 发布/订阅模式(一对多,消费者消费数据后不会清除消息)
消息生产者(发布)将消息发布到topic(主题)中,同时有多个消息消费者(订阅)消费该消息。和点对点方式不同,发布到topic的消息会被所有订阅者消费。
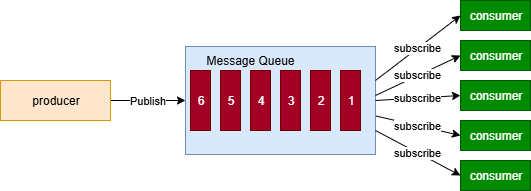
kafka通过引入consumer组(consumer group)来同时支持这两种模型。
3. Kafka是什么
Kafka是一个分布式的基于发布/订阅模式的消息队列,主要应用于大数据实时处理领域。
总结就是三句话:
生产者发送消息给kafka服务器
消费者从kafk服务器读取消息
kafka服务器依托zoookeeper集群进行服务的协调管理。
4. Kafka的使用场景
- 日志收集: 一个公司可以用Kafka可以收集各种服务的log,通过Kafka以统一接口服务的方式开放给各种consumer,例如hadoop\Hbase\Solr等。
- 消息队列系统: 解耦合生产者和消费者、缓存消息等。
- 用户活动跟踪: Kafka经常被用来记录web用户或者app用户的各种活动。如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到Kafka的topic中,然后订阅者通过订阅这些topic来做实事的监控分析,或者装载到hadoop、数据仓库中做离线分析和挖掘。
- 运营指标: Kafka也经常用来记录运营监控数据。包括收集各种分布式的应用数据,生产各种操作的集中反馈,比如报警和报告。
- 流式处理: 比如spark streaming和strom
5. 官网地址
二. 部署Kafka集群
Kafka架构
1. Kafka相关概念总结
producer: 消息生产者,发布消息到Kafka集群的终端或服务。
broker: Kafka集群中包含的服务器,一个Kafka服务就是一个broker。
topic: 每条发布到Kafka集群的消息属于的类别,生产者和消费者面向的都是一个topic。
patition: partition是物理上的概念,每个topic包含一个或多个partition。为了实现扩展性,一个非常大的topic可以分布到多个broker(即服务器)上,一个topic可以分为多个partition,每个partition都是一个有序的队列
consumer: 从Kafka集群中消费消息的终端或服务。
Consumer Group (CG): 消费者组,由多个consumer组成。消费者组内每个消费者负责消费不同的分区数据。一个分区只能由一个消费者消费;消费者组之间互不影响。所有的消费者都属于某个消费者组,即消费者组是逻辑上的一个订阅者。
replica: 副本,为保证集群中的某个节点发生故障时,该节点的partition数据不丢失,且Kafka仍然能继续工作,Kafka提供了副本机制,一个topic的每个分区都有若干副本,一个leader和若干个follower。
leader: 每个分区多个副本的"主",生产者发送数据的对象,以及消费者消费数据的对象都是leader。(replica中的一个角色,producer和consumer只跟leader交互)
follower: 每个分区多个副本中的"从",实时从leader中同步数据,保持和leader数据同步。leader发生故障时,某个follower会成为新的leader。
zookeeper: Kafka通过zookeeper来存储集群的meta信息。
2. Kafka版本的差异
1版本和2版本: 必须使用zookeeper作为协调者,存放Kafka元数据。
3版本: 可以选择zookeeper作为协调者也可以使用KRaft。
4版本: 只能使用KRaft。
Kafka版本3和4中新增的组件
controller: 群居的大脑 群集的选民列表 元数据
ISR: 分区的副本列表
OFffset: 消费者的偏移量。
meta.porpertise: 声明本节点的全部信息。